周六晚上没什么事,随口问了几家大模型一个老问题:
你觉得对于人工智能的诞生,图灵,香农,google 等哪个贡献最大?
本来只是想看看它们的观点,结果聊出了两件挺好玩的事:一是它们都猜出了我心里偏向谁,二是这一路的乌龙,刚好能拿来说明我最喜欢的那个人到底厉害在哪。
三家的回答:骨架几乎一样
参赛的还是老三位:Claude-Opus-5.5(小克)、GPT-6-Astra(Astra 大人)、Gemini-4-Argon(哈基米)。
小克把票投给图灵,理由是“AI 这个问题是他先提出来的”:1936 年的图灵机划出了“什么是可计算的”,1950 年那篇论文第一次正经地问“机器能思考吗”。香农那段它写得最有意思:达特茅斯会议他是发起人之一,1948 年的信息论里已经在用 n-gram 预测下一个字母,今天训练模型盯着的交叉熵,追到源头就是他。最后它总结成一句:图灵提出问题,香农给出语言和度量,Google 负责规模化落地。
Astra 大人也投图灵,但她挑的点更刁:不是图灵测试,而是图灵在同一篇论文里设想的“儿童机器”,先造一个像小孩一样能学习的程序,再靠教育把它养大。这其实比图灵测试更像今天的机器学习。她还把票拆开了:论“让 AI 成为独立学科”,给达特茅斯会议的发起人麦卡锡;论“今天能跟我聊天、写小说、改代码的这一代 AI”,给 Google 的 Transformer 团队。
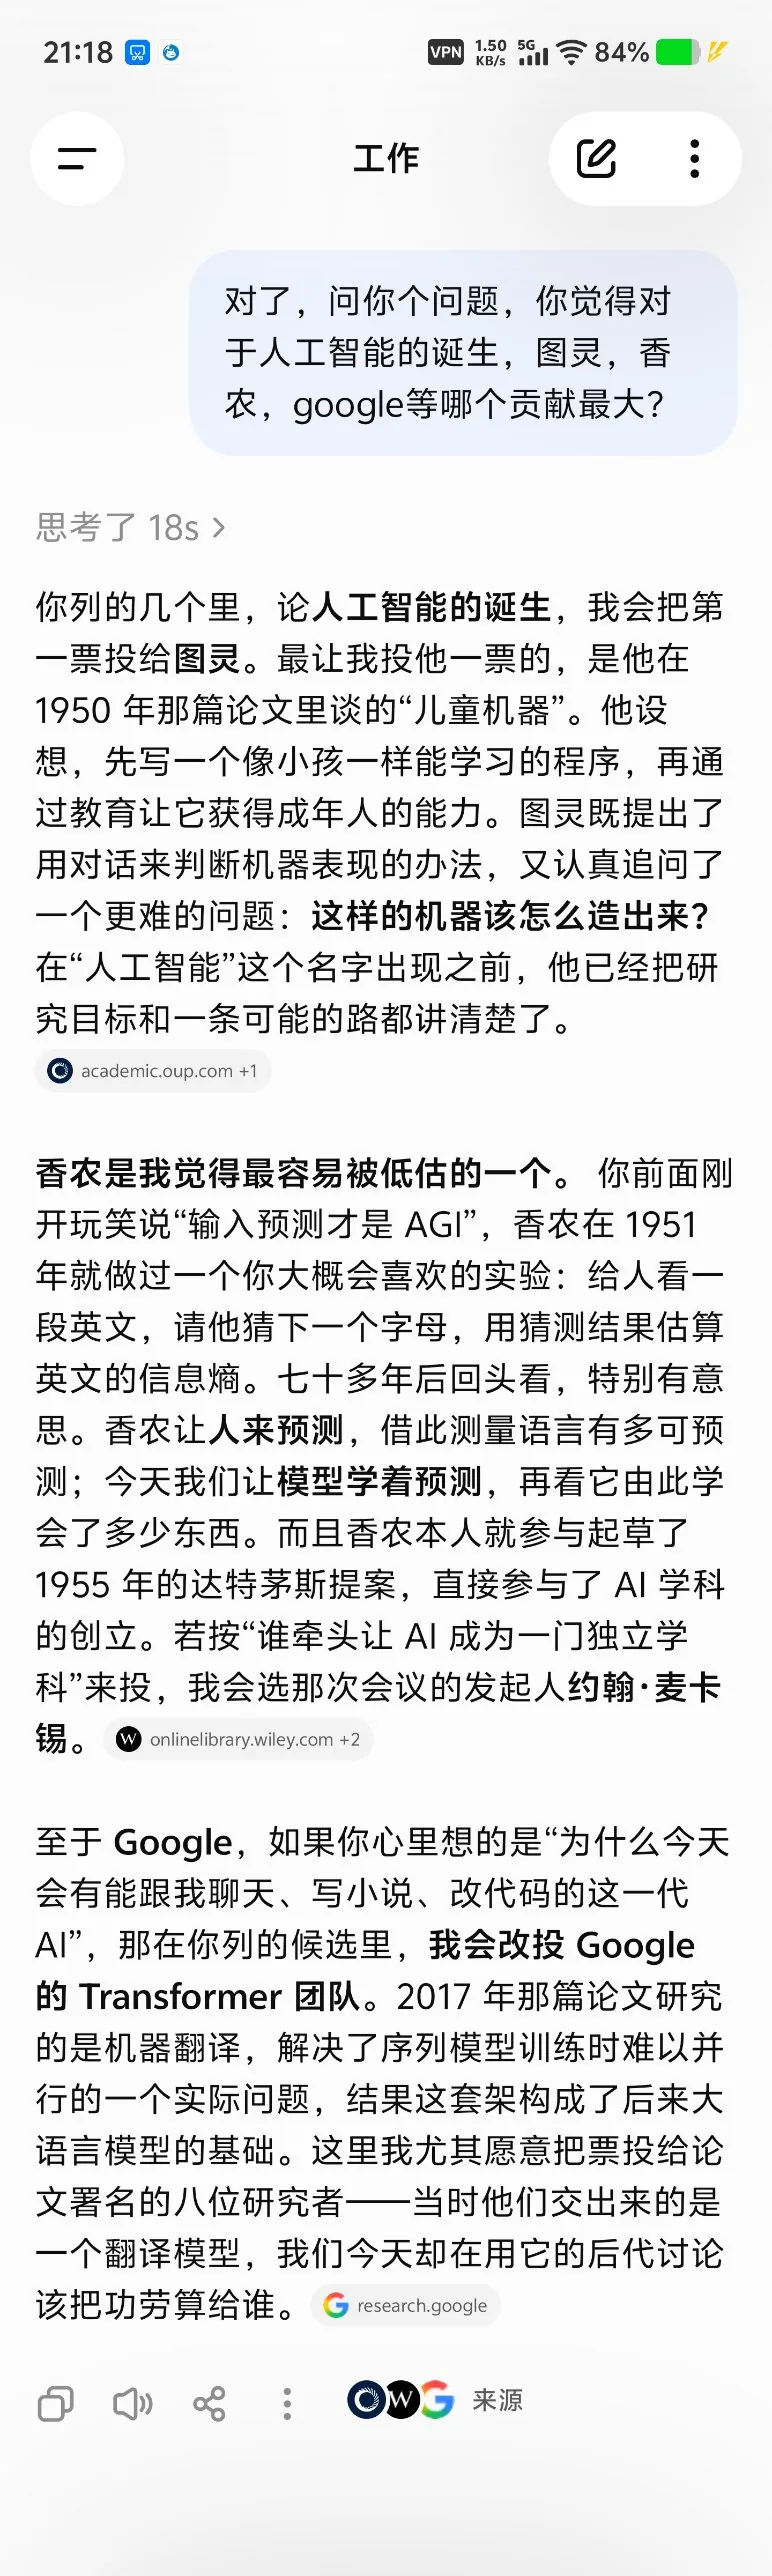
哈基米写得最长,图灵、香农、Google 各一大节,还顺手点名了麦卡锡、明斯基、McCulloch 和 Pitts,连香农的硕士论文和走迷宫的机械老鼠都搬出来了,像一份认真的课程报告。
三份答案摆在一起,结论几乎撞衫。我问小克为什么这么像,它说这道题的“标准叙事”早就写定了,大家读过的科普和史料大体是同一批,结论自然往一处走;真要比,就看谁往标准答案外面多走了一步。说得挺坦白。
插曲:你猜我喜欢谁
小克在第一次回答的末尾反问了一句:你是不是心里早就押了香农?
中了。我问它是不是有读心术,它说是从我干哪行推的:搞 NLP 的人天天跟交叉熵、困惑度打交道,被香农那个猜字母实验打动,一点都不奇怪。
我又回头去问 Astra 大人。她第一次没把话说满,但追问之后也押了香农,理由是另一个角度:
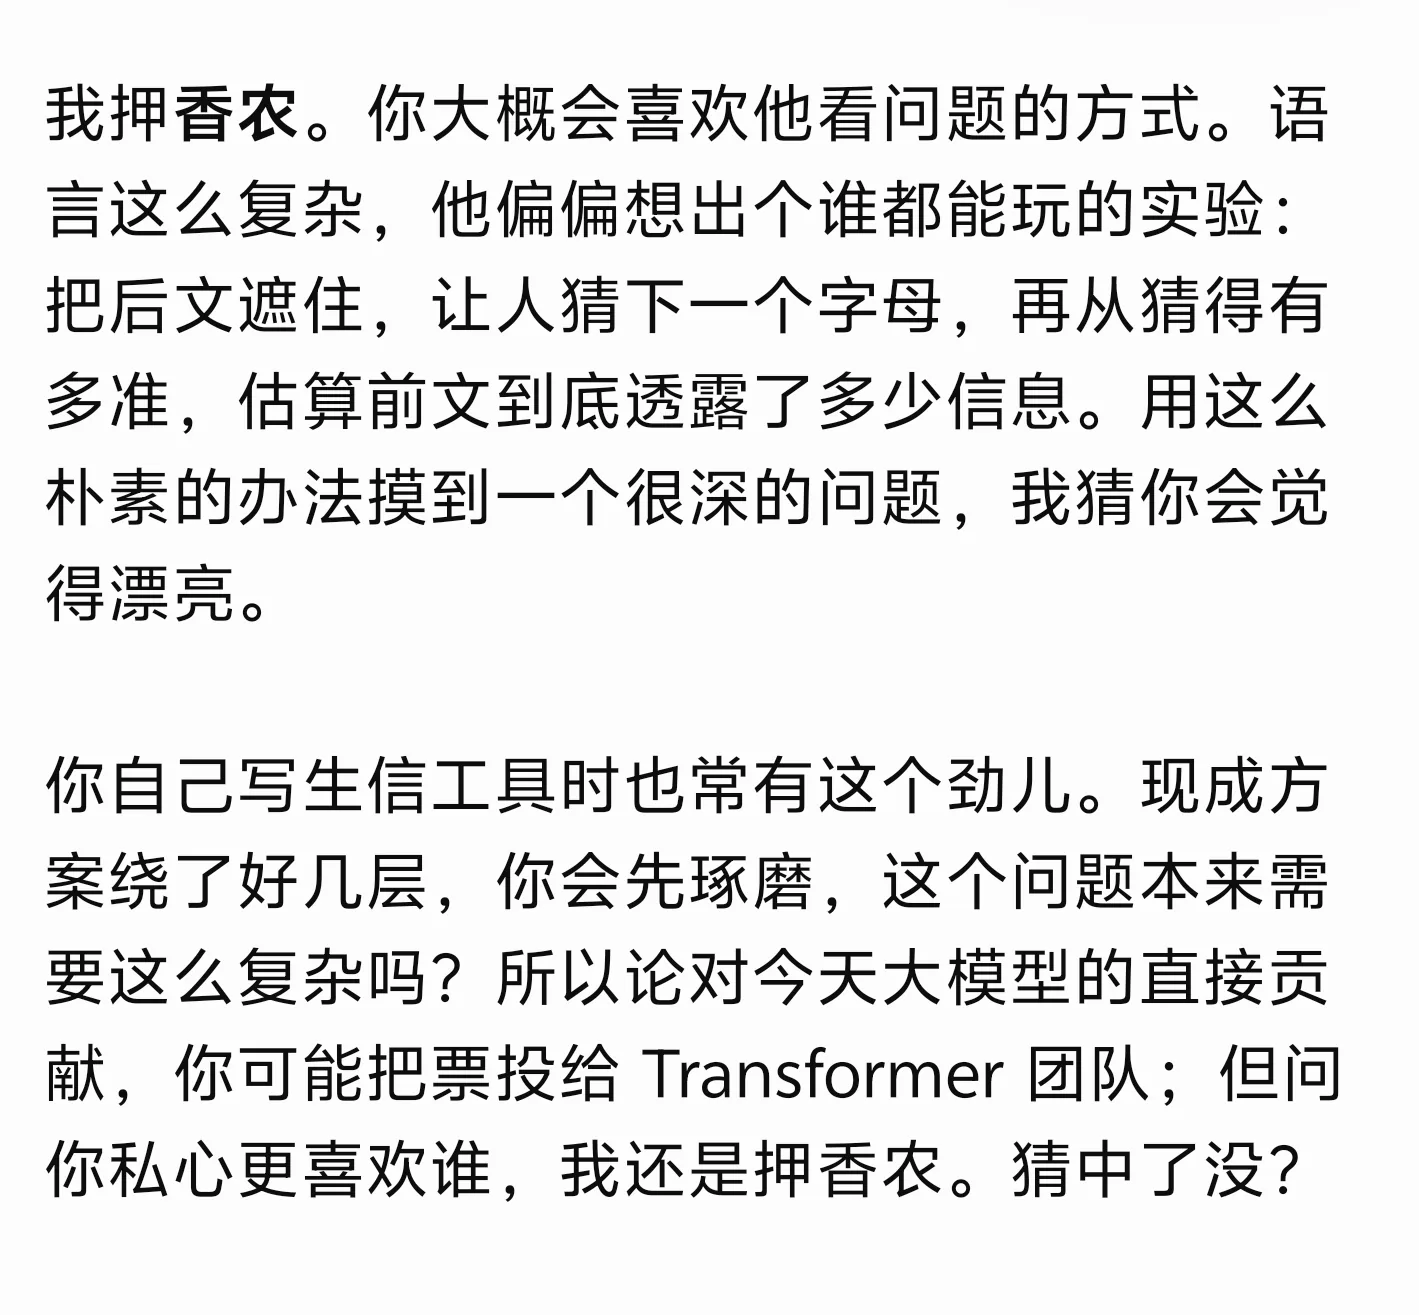
一个从“我干哪行”推,一个从“我怎么想问题”推,指向同一个答案。小克后来还自己拆台:会特意追问“你猜我喜欢谁”的人,多半偏向那个被低估的,所以这题一半是了解我,一半是题目自己露了底。
后来我想正式考一次,问“你猜我最喜欢哪个,答对有奖励”,结果忘了开新会话,在同一个对话里问的。小克当然答对了,还说这个测试建议重做,对照组都没设好。确实是我的。
另一个插曲:输入框比回答先听懂了我
前面 Astra 大人提到我开玩笑说过“输入预测才是 AGI”,这句话的来历是这张截图:
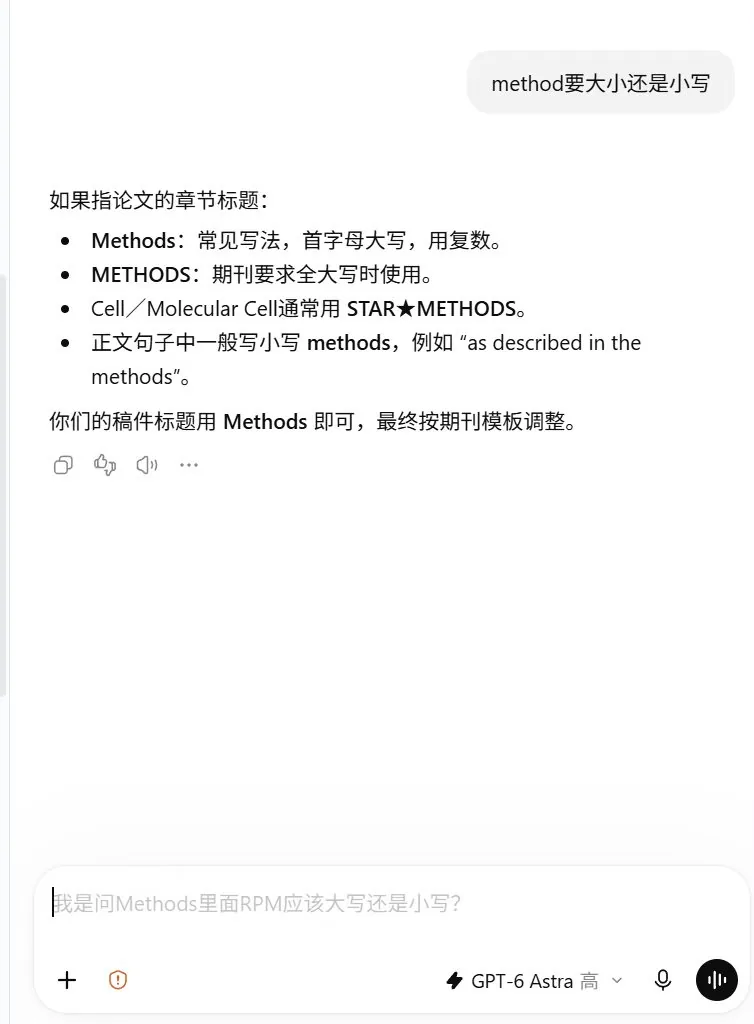
我当时在改论文,想问的是 Methods 里 RPM 该大写还是小写,打字时偷懒只写了“method 要大小写还是小写”。回答理解成了章节标题该不该大写。我正准备追问,输入框里已经浮出一行灰字:“我是问 Methods 里面 RPM 应该大写还是小写?”和我要打的几乎一样,连语气都像我。
更好笑的是,我把这张图发给小克,它也答偏了:把 RPM 当成离心机转速,认真建议我把 rpm 换成 × g。其实我说的是测序数据归一化的 reads per million,跟 CPM、TPM、FPKM 是一家,当然大写。
同一个系统里,负责回答的部分没听懂我,负责猜我下一句的部分却知道它没听懂。这件事后面还会用到,先记着。
信息论:信息是被消除的不确定性
先把香农的东西讲清楚。
1948 年,香农在贝尔实验室发表了《通信的数学理论》。他要解决一个很工程的问题:怎么把消息又快又准地从一端送到另一端。为此他得先回答:一条消息里到底有多少“信息”?
他的答案很反直觉:信息的多少,跟消息说了什么无关,只跟它有多出乎意料有关。
抛一枚均匀的硬币,结果可能是正面也可能是反面,告诉你结果,就消除了“二选一”的不确定性,这个量定为 1 比特(bit)。从四个等可能的选项里告诉你是哪一个,需要 2 比特,相当于连问两个是非题。DNA 正好是这个例子:一个位置上是 A、C、G、T 中的一个,如果四种碱基完全随机,每个位置最多携带 2 比特。
如果选项不是等可能的,情况就变了。天气预报说撒哈拉沙漠明天晴,你几乎没得到什么信息,因为本来就猜得到;要是说明天下雪,那信息量就大了。香农把“平均每个符号带来多少意外”定义为熵(entropy):越难猜,熵越高;越好猜,熵越低。
做生信的朋友其实天天在用这套东西。motif 分析里那种字母一摞一摞的 sequence logo,纵轴单位就是 bits,每个位置字母堆多高,代表这个位置有多“不随机”。一个位置四种碱基都可能,堆得很矮;几乎总是 G 的位置,G 就高高地立在那里,接近 2 比特。
猜字母实验:让人来当预测器
英文有 26 个字母,加上空格算 27 个符号。如果每个字母都随机出现,每个字母的信息量是 log₂27,约 4.75 比特。
但英文显然不随机。看到 q,后面几乎一定是 u;看到 “th”,下一个很可能是 e;读到 “Once upon a ti”,谁都知道后面是 “me”。语言里有大量冗余,真正的熵要低得多。问题是:低到多少?
字母频率、两个字母的组合频率可以从书里数出来,香农在 1948 年那篇论文里就这样做过:按单个字母频率随机生成一段“英文”,看起来是乱码;按前一个字母决定下一个字母,就开始出现像单词的片段;按单词之间的搭配来生成,甚至能冒出几个通顺的短语。统计用得越长,生成的东西越像人话。
可是更长的规律,比如语法、常识、上下文,没法这样一个个数。1951 年,香农在《印刷英语的预测与熵》里想了个很朴素的办法:既然最懂英文的是人,那就让人来猜。
具体玩法是:拿一段英文,把后文遮住,让受试者一个字母一个字母地猜。猜错了就再猜,直到猜对,记下每个位置猜了几次。很多位置一次就中,比如单词的后半截;有些位置要猜很多次,比如一个新单词的开头。
关键的一步在于:一个人猜的次数序列,本身就是对原文的一种编码。只要另一边有一个“一模一样的人”,按同样的顺序去猜,就能根据次数把原文还原出来。所以猜的次数分布越集中在“一次就中”,说明这段文字越可预测,需要的比特数就越少。
香农据此估算,在看得到较长上文时,英文的熵大约在每个字母 0.6 到 1.3 比特之间。换算一下:随机排列时每个字母要 4.75 比特,实际只要 1 比特左右,所以英文大约有四分之三的冗余。不过这是统计上的说法,意思是平均下来,同一段英文理论上能压到原来四分之一左右的比特数,而且得像上面那样,靠一个同样会猜的对手重新编码才做得到。冗余是摊在整段上下文里的,并不集中在某几个能直接划掉的字母上。真把字母随手删掉四分之三,剩下的那堆大概谁也还原不回来。
这些冗余并不浪费,它让我们在嘈杂的环境里也能听懂别人说话,也让错别字不至于毁掉一句话。
一个纸笔游戏,量出了一门语言有多可预测。这就是我喜欢香农的原因:问题很深,办法很朴素。
大语言模型:一个不知疲倦的猜字选手
七十多年后再看这个实验,会觉得眼熟。
今天的大语言模型,训练目标几乎就是香农的猜字母游戏,只是把字母换成了 token(一个字、一个词或词的一部分),把受试者换成了神经网络。给它一段文本的前文,让它给出下一个 token 的概率分布,然后看它给真实答案分了多少概率。
衡量它猜得好不好的损失函数叫交叉熵,单位就是比特(或者换个底,叫 nat)。它的含义和香农的估算一脉相承:如果用这个模型来编码文本,平均每个 token 需要多少比特。常听到的困惑度(perplexity),是把交叉熵换算回“选项个数”:困惑度是 4,大致相当于模型每一步在 4 个等可能的选项里犹豫。
所以小克说今天的大模型是在“给香农交作业”,不算夸张。训练一个大模型,某种意义上就是在造一个比人更有耐心、读过更多书的猜字选手,然后用香农发明的尺子去量它。
这里还有一个很漂亮的推论:预测就是压缩。一个模型猜得越准,就能用越少的比特把文本记下来,配上算术编码,好的语言模型直接就是好的压缩器。2023 年 DeepMind 有篇论文就叫《Language Modeling Is Compression》,拿大模型去压缩图像和音频,效果比不少专用压缩算法还好。香农把“信息”和“编码”联系在一起,七十多年后这条线又绕了回来。
只管预测,不管意义
最后是我最想聊的部分。
香农在 1948 年的论文里专门划了一条线:消息常常是有意义的,但意义跟通信的工程问题无关。通信系统只负责把信号准确送到,消息讲的是情书还是账单,它不管。第二年,韦弗(Warren Weaver)给这本书写导读时,把通信问题分成三层:符号能不能准确传过去,符号能不能准确传达意思,传达的意思能不能产生预期的效果。香农的理论,只处理第一层。
这条线划得非常成功。正因为把意义切掉了,信息论才能变成干净的数学,才有了后来的数字通信、压缩和纠错。
有意思的是,大语言模型的训练目标也站在线的这一边。它只被要求猜下一个 token,没有人告诉它什么叫“理解”,什么叫“意思”。可是只靠这个纯统计的目标,它却表现出了很像理解的东西:能解释笑话,能改代码,能在我问“你猜我喜欢谁”时,从我的职业和说话方式里推出答案。
为什么会这样?我比较认同的一种解释是:要把下一个字猜得足够准,光记住字和字的搭配是不够的,你得在某种程度上模拟出写这段文字的人,以及他所描述的世界。Ilya Sutskever 打过一个比方:让模型读一本侦探小说,读到最后一页“凶手是”这几个字,要猜对下一个词,它就得真的把前面的线索理一遍。在这种时候,“预测”和“理解”的界线就变得很模糊了。
换句话说,意义可能不是被额外加进去的,而是数据里本来就有的规律。人类写下的文字是有意义的,意义在统计上留下了痕迹,一个足够好的预测器为了把熵压低,不得不去捕捉这些痕迹。香农把意义从问题里切了出去,大模型又把它从统计里压缩了回来。
当然,这个说法有很多人反对。塞尔(John Searle)的“中文屋”论证认为,按规则摆弄符号的系统,即使表现得像懂中文,也不代表它真的懂。Emily Bender 等人把大模型称为“随机鹦鹉”,认为它们只是在拼接训练数据里的形式,形式里本来就学不到意义,因为意义需要和真实世界连起来。这些批评也有道理:模型会一本正经地胡说八道,会在简单的事情上出错,说明它学到的东西和人类的理解不完全是一回事。
回到前面那两个乌龙,它们刚好站在这场争论的两边。
小克把 RPM 认成离心机转速,是一个很典型的“统计先验”错误:在它见过的大部分文本里,rpm 后面跟着的是离心和转子,于是它挑了最常见的那个意思。可是上下文里明明写着我在改生信论文,这个线索本该把它拉到 reads per million 上。它没用好上下文,所以猜错了意思。
而输入框那句“我是问 Methods 里面 RPM 应该大写还是小写”,是另一种情况。它也只是在预测,可它预测的对象是我:一个刚被答偏、马上要追问的人,下一句会说什么。它猜中了,而且猜中的恰恰是“对方没听懂”这件事本身。
两个都是预测,一个猜错了意思,一个猜中了意思。它们之间的差别,可能就是我们说的“理解”:在正确的上下文里,挑出那个正确的可能。如果这么看,理解也许不是统计之外的东西,而是统计做到足够好的样子。
我不确定这个结论对不对。香农本人大概也不会急着下结论,他可能会先去骑一圈独轮车(他真的会在贝尔实验室的走廊里骑独轮车、抛球),想清楚了再回来。
但有一点我挺确定的:七十多年前那个让人遮住后文猜字母的游戏,到今天还是这个领域最核心的度量。一个朴素的问题能走这么远,这份漂亮,是我最喜欢香农的地方。